

NPU vs GPU vs CPU: Memilih Hardware Terbaik untuk AI Lokal
 Irfan Mulyana
October 16, 2026 7:24 am
.
10 min read
Verdict Cepat
GPU tetap pilihan utama untuk menjalankan model bahasa (LLM) lokal seperti Llama, Qwen, atau Mistral lewat Ollama. NPU memang memamerkan angka TOPS yang tinggi di brosur, tetapi benchmark nyata justru menempatkan NPU di bawah CPU untuk inferensi LLM. Faktor yang paling menentukan kecepatan bukanlah TOPS, melainkan kapasitas RAM dan bandwidth memori. Ringkasnya: GPU NVIDIA untuk kecepatan maksimal, RAM besar plus memori terpadu untuk model besar, CPU sebagai cadangan yang selalu bisa diandalkan.
Istilah NPU muncul di hampir setiap brosur laptop baru. Intel, AMD, Qualcomm, dan Apple sama-sama memamerkan angka TOPS (trillion operations per second) sebagai bukti bahwa perangkat mereka siap untuk era AI. Di sisi lain, komunitas pengguna model AI lokal tetap mengandalkan GPU, bahkan GPU kelas menengah. Mana yang benar untuk kebutuhan menjalankan AI langsung di perangkat, tanpa cloud?
Saya merangkum data spesifikasi resmi vendor dan sejumlah benchmark independen yang menguji ketiga jenis prosesor ini secara langsung pada beban kerja yang sama: inferensi model bahasa lokal. Hasilnya cukup mengejutkan dan mengubah cara saya menilai spesifikasi laptop untuk AI.
Angka TOPS Bukan Penentu Utama Kecepatan AI Lokal
TOPS mengukur berapa triliun operasi yang bisa dilakukan sebuah chip per detik. Angka ini dipakai sebagai patokan program Copilot+ PC dari Microsoft, yang mensyaratkan NPU minimal 40 TOPS. Berikut angka resmi dari masing-masing vendor, merujuk pada perbandingan yang diterbitkan Local AI Master:
| Chip | NPU | Memori Maksimal |
|---|---|---|
| Qualcomm Snapdragon X2 Elite | 80 TOPS | 128 GB |
| AMD Ryzen AI 400 | 60 TOPS | Tergantung OEM |
| Intel Panther Lake (Core Ultra 300) | 50 TOPS | Sekitar 32 GB |
| Intel Lunar Lake (Core Ultra 200V) | 48 TOPS | Sekitar 32 GB |
| Apple M4 Max | Sekitar 38 TOPS | 128 GB |
Semua chip di atas sudah melewati batas minimal 40 TOPS untuk Copilot+ PC. Artinya, untuk kebutuhan AI sehari-hari seperti peningkatan kualitas gambar, blur latar video call, atau transkripsi suara, perbedaannya sudah tidak terasa. Kesimpulan yang ditarik situs perbandingan tersebut cukup tegas: the best NPU is the one attached to the right memory, not the one with the biggest TOPS number. NPU terbaik adalah yang terpasang pada memori yang tepat, bukan yang punya angka TOPS terbesar.
Alasannya sederhana. Inferensi model bahasa bersifat memory-bound, bukan compute-bound. Setiap token yang dihasilkan mengharuskan seluruh bobot model dibaca ulang dari memori. Jadi kecepatan membaca memori, bukan jumlah operasi per detik, yang menjadi hambatan utama.
CPU: Cadangan yang Selalu Ada dan Bisa Diandalkan
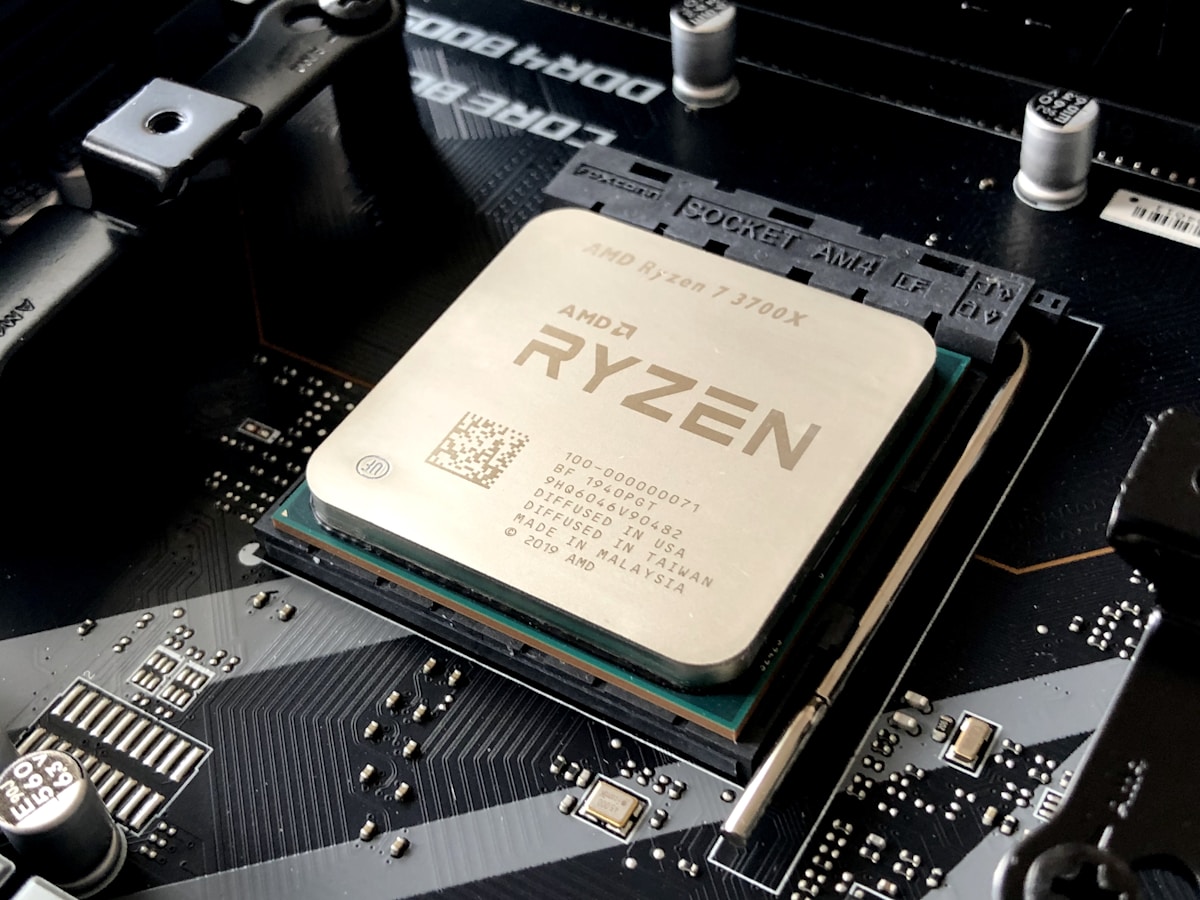
CPU adalah pilihan paling universal untuk menjalankan model AI lokal. Setiap perangkat memilikinya, dan semua framework inferensi seperti llama.cpp atau Ollama bisa berjalan di CPU tanpa konfigurasi khusus. Kelemahannya jelas: kecepatan terbatas.
Data dari panduan menjalankan LLM di CPU menunjukkan gambaran yang realistis. Model 7B parameter dalam presisi penuh (FP32) membutuhkan sekitar 28 GB RAM dan menghasilkan sekitar 10 token per detik. Dengan kuantisasi 4-bit (Q4), kebutuhan RAM turun drastis menjadi sekitar 3,5 GB dengan kecepatan 8 sampai 10 token per detik, merujuk pada analisis Ucartz.
Namun pada perangkat konsumen biasa, angkanya lebih rendah lagi. Sebuah benchmark independen pada laptop Intel Core Ultra 7 258V dengan model Qwen3 8B terkuantisasi INT4 mencatat CPU menghasilkan sekitar 7,4 token per detik. Angka yang menarik: pada pengujian yang sama, NPU hanya mencapai 5,2 token per detik. CPU justru mengalahkan NPU untuk beban kerja ini, menurut dokumentasi proyek nollama di GitHub.
Saya melihat CPU sebagai fondasi. Model kecil seperti Phi atau TinyLlama berjalan cukup lancar di CPU untuk kebutuhan kasual. Untuk pembahasan model-model ringan yang cocok di CPU, pembahasan optimasi konteks Ollama untuk coding lokal ringan di situs ini bisa menjadi rujukan lanjutan.
GPU: Mesin Utama untuk Model Bahasa Lokal
GPU adalah pemenang yang tidak terbantahkan untuk inferensi LLM lokal saat ini. Arsitekturnya yang paralel sangat cocok untuk operasi matriks yang menjadi inti kerja model bahasa. Semua benchmark independen mengarah ke kesimpulan yang sama.
Sebuah panduan setup Ollama multi-perangkat menguji model Llama 3 7B pada hardware yang sama dengan hasil yang kontras: NPU hanya mencapai 4 token per detik (52 detik untuk 200 token), GPU Intel terintegrasi mencapai 18 token per detik, dan GPU NVIDIA mencapai 58 token per detik atau hanya 3,6 detik untuk 200 token. CPU bahkan lebih lambat lagi di angka 2 token per detik. Data ini dipublikasikan dalam benchmark multi-instance Ollama yang cukup detail.
Hal yang sama terlihat pada GPU terintegrasi. Pada laptop Core Ultra 7 258V yang sama, GPU Intel Arc 140V menghasilkan teks sekitar 3 kali lebih cepat dibanding NPU untuk model yang sama. Jadi urutan performa untuk LLM lokal di perangkat konsumen adalah: GPU diskrit, lalu GPU terintegrasi, lalu CPU, dan NPU di posisi terbawah.
Namun GPU punya syarat yang tidak bisa ditawar: memori video (VRAM) yang cukup. Sebuah model 7B parameter dengan kuantisasi Q4_K_M membutuhkan sekitar 4,5 GB hanya untuk bobot, ditambah cache KV yang membesar seiring panjang konteks. Praktisnya, 6 GB VRAM terasa sempit dan 8 GB baru nyaman untuk konteks pendek, menurut proyek benchmark local-ai-hardware-bench. Ketika model tidak muat di VRAM, sebagian layer terpaksa berjalan di CPU dan kecepatan jatuh drastis, bisa sampai 5,8 kali lebih lambat pada kurva yang mereka ukur.
Di sinilah memori terpadu (unified memory) milik Apple menunjukkan kelebihannya. Mac dengan chip Apple Silicon tidak memisahkan RAM dan VRAM, sehingga seluruh kapasitas memori bisa dipakai untuk model. Mac Studio M5 Max dengan bandwidth memori 460 GB/s mampu menembus sekitar 90 token per detik untuk model 7B. Sebagai perbandingan, mini PC dengan RAM DDR5 biasa yang bandwidth-nya sekitar 89,6 GB/s hanya mampu belasan token per detik untuk model yang sama, seperti dihitung dalam ulasan ComputingForGeeks.
NPU: Spesialis yang Belum Siap untuk LLM
NPU dirancang untuk beban kerja AI yang kecil, tetap, dan sudah dioptimasi vendor: pengenalan wajah, peningkatan kualitas foto, peredam bising, atau transkripsi real-time. Untuk tugas-tugas itu, NPU sangat efisien karena berjalan dengan daya yang jauh lebih rendah dibanding GPU.
Masalahnya, model bahasa generatif bukan beban kerja yang cocok untuk NPU saat ini. NPU di chip konsumen hanya menjalankan model kecil yang sudah disetel vendor melalui runtime khusus. Sementara itu, llama.cpp dan Ollama, dua fondasi utama ekosistem AI lokal, berjalan di atas GPU, bukan NPU. Ulasan ComputingForGeeks menyimpulkannya dengan lugas: mini PC yang dijual dengan keunggulan NPU bukanlah jalan pintas untuk LLM lokal.
Ada pengecualian yang menarik. Proyek nollama membangun API yang kompatibel dengan Ollama khusus untuk NPU Intel (AI Boost) lewat OpenVINO. Hasilnya: NPU memang bisa menjalankan chat teks, tetapi throughput-nya kalah dari CPU pada model yang sama. Kombinasi yang justru masuk akal adalah mode ganda: permintaan teks ringan ke NPU sambil GPU menangani model yang lebih besar atau pemrosesan gambar. Ini menunjukkan NPU punya peran, tetapi bukan sebagai mesin utama LLM.
Jika kebutuhan Anda lebih ke arah laptop hemat daya untuk kerja AI ringan, panduan workstation mini 128GB untuk AI lokal memberi gambaran perangkat ekstrem di sisi kapasitas memori.
Tabel Perbandingan dan Rekomendasi Hardware
| Aspek | CPU | GPU | NPU |
|---|---|---|---|
| Kecepatan LLM 7B (tok/s) | 2 sampai 10 | 18 sampai 58+ | 4 sampai 5 |
| Model yang didukung | Semua model | Semua model | Model kecil vendor saja |
| Kuantisasi Q4 7B | Bisa, ~3,5 GB RAM | Bisa, ~4,5 GB VRAM | Terbatas |
| Ketersediaan | Semua perangkat | Butuh GPU mumpuni | Laptop AI generasi baru |
| Efisiensi daya | Sedang | Boros | Sangat hemat |
| Peran ideal | Cadangan universal | Mesin utama LLM | AI kecil always-on |
Angka token per detik di tabel merujuk pada kecepatan yang terasa saat membaca teks yang dihasilkan. Patokan yang dipakai proyek local-ai-hardware-bench: sekitar 7 sampai 10 token per detik sudah mengimbangi kecepatan baca, dan 20 token per detik ke atas terasa instan. Untuk code completion atau alur kerja agen yang memicu ratusan pemanggilan, yang lebih penting justru time to first token: jeda 200 milidetik pada 30 token per detik terasa lebih cepat dibanding jeda 2 detik pada 80 token per detik.
Tidak ada satu jawaban untuk semua orang. Berikut panduan praktis berdasarkan skenario yang paling umum saya temui:
Untuk chat dan coding ringan: laptop apa pun dengan RAM 16 GB sudah cukup. Jalankan model 7B sampai 8B terkuantisasi Q4 di CPU atau GPU terintegrasi. Kecepatan belasan token per detik sudah nyaman untuk percakapan. Model seperti Qwen 2.5 Coder atau DeepSeek untuk coding lokal bisa dibandingkan lebih lanjut di artikel perbandingan Qwen 2.5 Coder vs DeepSeek V3.
Untuk performa maksimal di desktop: GPU NVIDIA diskrit dengan VRAM 12 GB atau lebih adalah standar emas. Ini membuka model 13B sampai 32B dengan kecepatan puluhan token per detik. Pastikan seluruh layer model ter-offload ke GPU; layer yang tercecer di CPU langsung memangkas kecepatan.
Untuk model besar di atas 30B parameter: lupakan VRAM diskrit biasa. Pilih perangkat dengan memori terpadu besar seperti Mac dengan 64 GB memori ke atas, atau workstation dengan RAM 128 GB yang dijalankan penuh di CPU dengan kecepatan yang masih bisa diterima untuk pemakaian personal.
Untuk laptop tipis hemat baterai: NPU membantu untuk fitur AI bawaan sistem operasi, tetapi jangan membeli laptop semata-mata karena angka TOPS NPU-nya jika targetnya adalah LLM lokal. Prioritaskan RAM besar dan GPU terintegrasi yang kuat.
Sebagai catatan tambahan, penyimpanan cepat juga memengaruhi pengalaman: model yang dimuat dari SSD NVMe terasa jauh lebih responsif dibanding HDD. Panduan memilih SSD NVMe dan SATA untuk laptop lawas membahas upgrade yang murah tetapi berdampak besar ini.
Kesalahan Umum yang Perlu Dihindari
Dari data di atas, ada beberapa jebakan yang sering saya lihat saat orang memilih hardware untuk AI lokal:
1. Membeli berdasarkan angka TOPS semata. TOPS mengukur operasi INT8 pada beban kerja yang sudah dioptimasi. Inferensi LLM justru dibatasi bandwidth memori, bukan jumlah operasi. Laptop dengan NPU 80 TOPS tetapi RAM 16 GB akan kalah jauh dari perangkat dengan memori 64 GB untuk model besar.
2. Mengabaikan kebutuhan konteks. Bobot model hanyalah separuh cerita. Cache KV tumbuh seiring panjang percakapan. Model yang muat saat chat pendek bisa meluber ke CPU saat konteks memanjang, dan kecepatan anjlok seketika. Sisakan ruang kepala minimal 2 sampai 4 GB di atas ukuran file model.
3. Menganggap NPU bisa menggantikan GPU untuk Ollama. Sampai ekosistem berubah, Ollama dan llama.cpp berjalan di GPU. NPU hanya berguna lewat runtime khusus vendor dengan model yang terbatas. Jangan berharap instalasi Ollama standar tiba-tiba memakai NPU.
4. Memilih model terlalu besar untuk hardware. Model 70B di CPU bisa memakan waktu menit untuk satu respons. Lebih baik model 8B yang responsif dibanding model 32B yang memaksa menunggu lama. Kualitas model kecil modern sudah sangat baik untuk mayoritas tugas.
5. Lupa soal platform. Pilihan software juga menentukan. Perbandingan platform di artikel Ollama vs LM Studio membantu memutuskan antarmuka yang paling cocok setelah hardware beres.
Kesimpulan dan Langkah Selanjutnya (CTA)
Perang angka TOPS di brosur laptop memang menarik, tetapi tidak menjawab pertanyaan yang sebenarnya: seberapa cepat model bahasa berjalan di sebuah perangkat. Jawabannya ditentukan oleh tiga hal berurutan: kapasitas memori yang cukup untuk menampung model, bandwidth memori yang tinggi untuk membacanya berulang-ulang, dan GPU yang mampu mengeksekusinya.
NPU tetap punya tempat: tugas AI kecil yang selalu menyala dengan daya minimal. CPU tetap menjadi cadangan universal yang selalu bisa diandalkan. Tetapi untuk menjalankan LLM lokal yang sesungguhnya hari ini, GPU adalah jawabannya, dan RAM besar adalah investasi yang paling tidak akan mengecewakan.
Mulailah dari kebutuhan, bukan dari spesifikasi. Tentukan model terbesar yang ingin dijalankan, hitung kebutuhan memorinya dengan kuantisasi Q4, tambahkan ruang untuk konteks, lalu pilih perangkat yang memenuhi angka itu. Dengan pendekatan ini, Anda tidak akan membayar mahal untuk angka TOPS yang tidak pernah terpakai.
Langkah selanjutnya: unduh Ollama, tarik satu model 7B terkuantisasi, lalu ukur sendiri token per detik di perangkat tersebut. Angka dari hardware sendiri selalu lebih meyakinkan daripada brosur mana pun. Jika hasilnya di bawah 7 token per detik untuk chat, pertimbangkan model yang lebih kecil atau upgrade RAM sebelum mengganti perangkat.