
RAG vs Fine-Tuning: Panduan Memilih Strategi AI yang Tepat
 Irfan Mulyana
October 12, 2026 6:31 pm
.
8 min read
Verdict Cepat
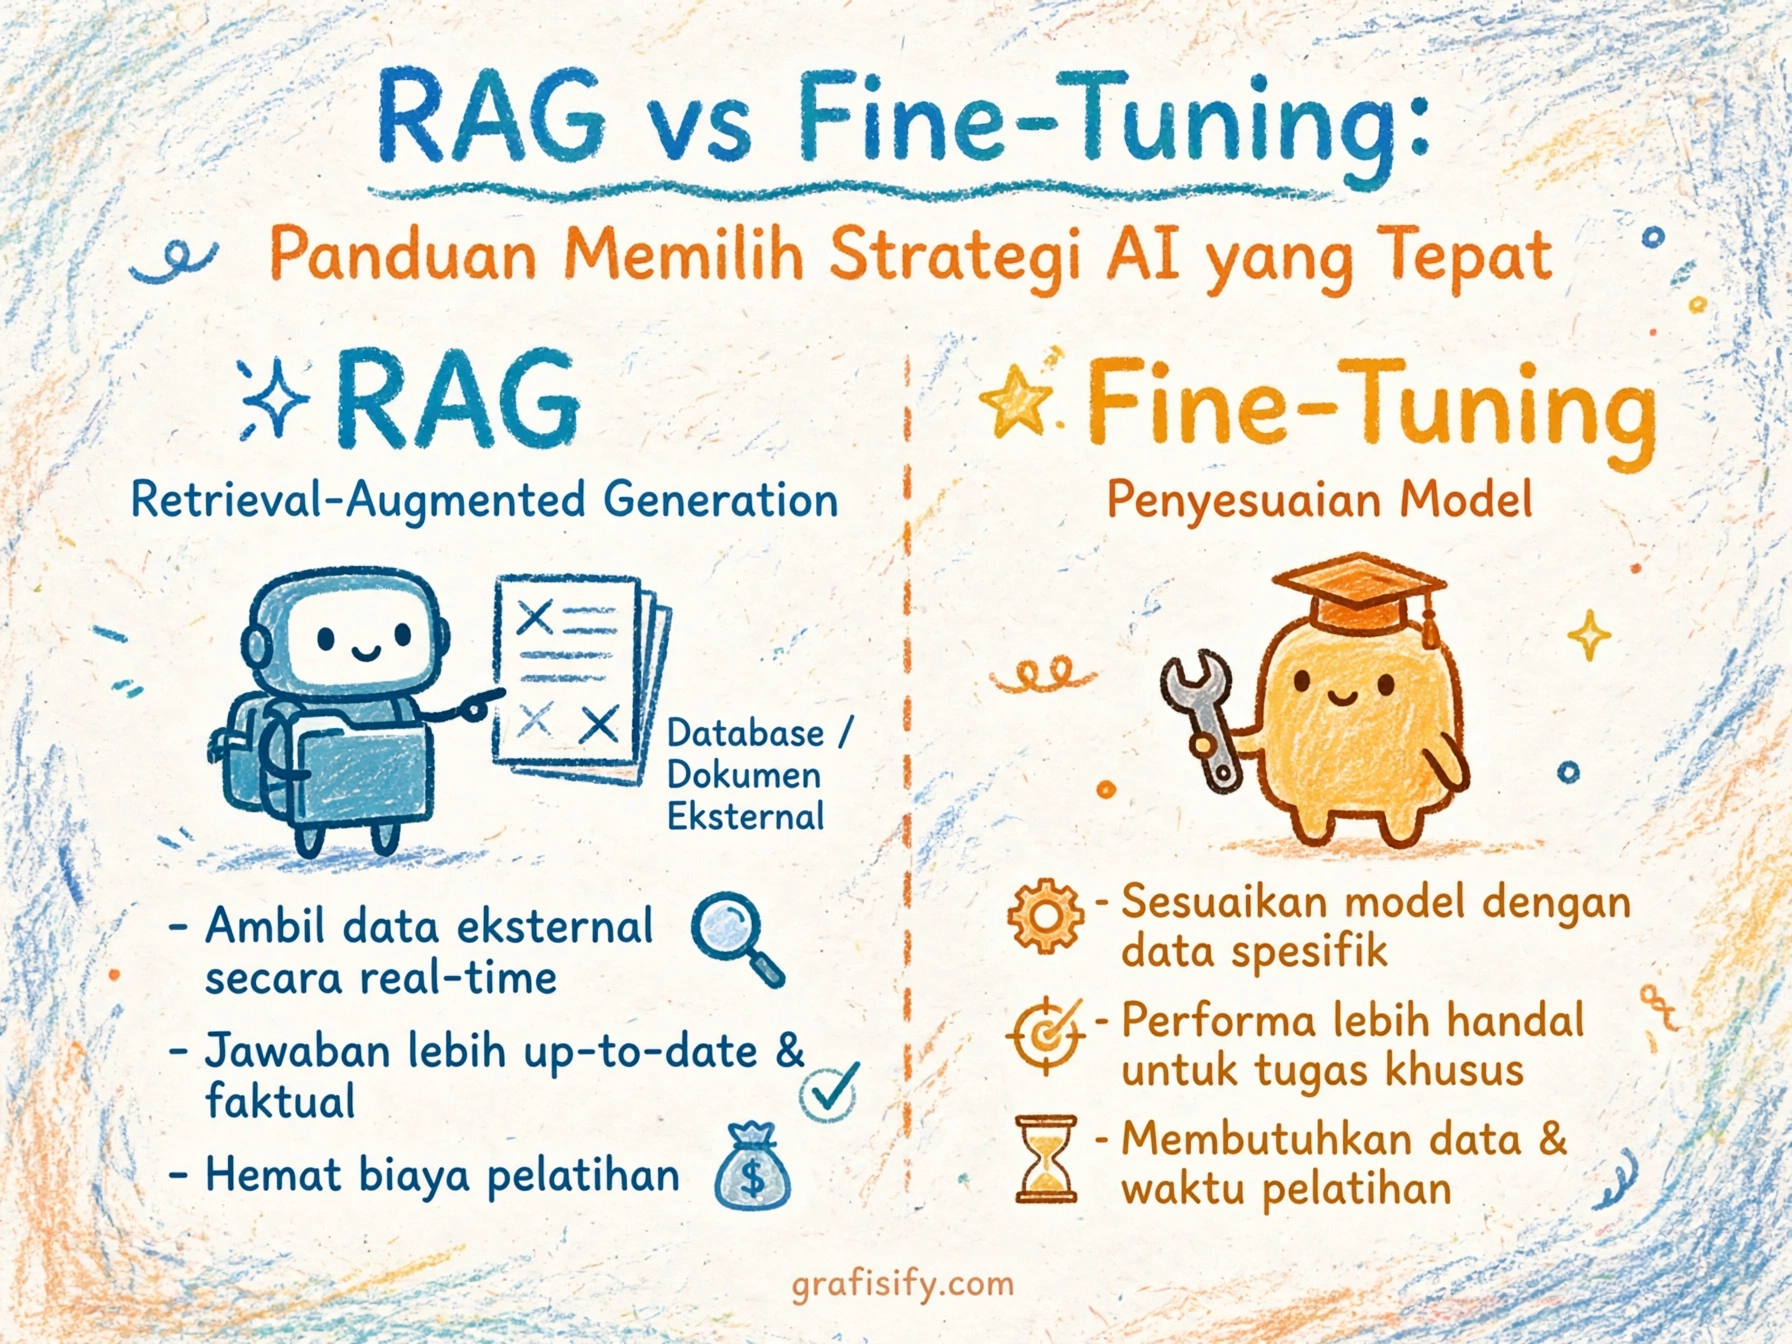
Singkatnya: RAG menambah pengetahuan ke model AI tanpa mengubah bobotnya, cocok untuk data yang sering berubah dan jawaban yang butuh rujukan sumber. Fine-tuning mengubah perilaku model lewat pelatihan ulang, cocok untuk tugas sempit yang berulang dengan format output tetap. Kebanyakan sistem produksi akhirnya memakai keduanya: fine-tuning mengatur bentuk jawaban, RAG menjaga kebenaran fakta. Panduan ini membantu menentukan pendekatan mana yang paling pas untuk kebutuhan spesifik sebuah proyek AI.
Kenapa Pemilihan Strategi Ini Penting
Banyak tim memulai proyek AI dengan pertanyaan yang keliru: model mana yang dipakai. Padahal pertanyaan yang lebih menentukan keberhasilan adalah bagaimana model tersebut diberi kemampuan khusus. Model AI generik seperti GPT, Claude, atau Llama memang pintar secara umum, tapi mereka punya dua kelemahan struktural: pengetahuan mereka berhenti di tanggal training terakhir, dan mereka tidak tahu apa-apa tentang dokumen internal perusahaan.
Dua pendekatan utama untuk mengatasi masalah ini adalah RAG (Retrieval-Augmented Generation) dan fine-tuning. Keduanya sering dibicarakan seolah bersaing, padahal mereka menyelesaikan masalah yang berbeda. Memilih yang salah bisa berarti biaya melambung, jawaban tidak akurat, atau proyek yang tidak pernah mencapai produksi.
Saya sudah melihat pola ini berulang di berbagai implementasi: tim yang memaksa fine-tuning untuk data yang berubah tiap minggu akhirnya terjebak siklus retraining tanpa akhir, sementara tim yang memakai RAG untuk tugas klasifikasi tiket sederhana justru membayar mahal karena setiap jawaban harus membaca ulang dokumen yang sama. Artikel ini membedah perbedaan keduanya secara praktis agar keputusan diambil berdasarkan kebutuhan, bukan tren.
Apa Itu RAG dan Kapan Ia Bersinar
RAG bekerja dengan cara sederhana: sebelum model menjawab, sistem mencari dulu dokumen yang relevan dari basis pengetahuan, lalu menempelkan potongan dokumen itu ke dalam prompt. Model kemudian menjawab berdasarkan konteks yang baru saja diambil. Pengetahuannya tidak berubah, tapi ia selalu membaca sumber terbaru setiap kali ditanya.
Keunggulan utama RAG ada di tiga hal. Pertama, data selalu segar. Menambah pengetahuan baru semudah mengunggah dokumen ke vector database, tanpa perlu melatih ulang model. Kedua, jawaban bisa dilacak sumbernya. Karena setiap jawaban dibuat dari potongan dokumen tertentu, sistem bisa menunjukkan persis dokumen mana yang menjadi rujukan. Ini krusial untuk industri yang diatur ketat seperti keuangan, hukum, dan kesehatan. Ketiga, risiko halusinasi turun drastis. Studi lapangan yang dikutip Mordor Intelligence mencatat penurunan halusinasi sebesar 70 sampai 90 persen pada sebagian deployment RAG, meski hasilnya sangat tergantung pada kualitas retrieval dan desain korpus.
RAG paling cocok untuk chatbot layanan pelanggan yang menjawab dari manual produk, asisten pengetahuan internal, pencarian dokumen legal, dan sistem pendukung penjualan yang butuh data terkini. Prinsipnya: pilih RAG ketika model sebenarnya sudah cukup pintar, tapi tidak punya akses ke konteks yang tepat.
Untuk yang tertarik membangun infrastruktur RAG sendiri, panduan setup Qdrant vector database lokal untuk RAG dan panduan setup ChromaDB lokal untuk proyek AI di Grafisify membahas langkah teknisnya dari nol. Pembaca yang nyaman dengan bahasa Inggris juga bisa membaca perbandingan vector database pgvector vs Pinecone vs Qdrant untuk memilih mesin penyimpanan yang tepat sebelum membangun pipeline retrieval.
Apa Itu Fine-Tuning dan Kapan Ia Unggul
Fine-tuning mengambil pendekatan sebaliknya: alih-alih memberi dokumen saat inferensi, bobot model dilatih ulang memakai dataset khusus domain. Hasilnya model yang secara permanen “terbiasa” dengan pola, gaya, atau tugas tertentu, tanpa perlu instruksi panjang di setiap prompt.
Kekuatan fine-tuning ada di konsistensi perilaku. Ketika output harus selalu berbentuk JSON yang valid, mengikuti gaya bahasa brand tertentu, atau mengklasifikasikan ribuan tiket dengan format seragam, fine-tuning mengunci pola itu ke dalam model. Prompt engineering bisa meniru hasil serupa, tapi cenderung goyang pada volume tinggi: sedikit perubahan frasa bisa merusak konsistensi. Model yang di-fine-tune tidak punya masalah ini karena perilakunya sudah tertanam.
Fine-tuning paling cocok untuk tugas sempit yang berulang: klasifikasi tiket, ekstraksi data terstruktur, pembuatan deskripsi produk dalam format baku, ringkasan kepatuhan, dan analisis sentimen. Syaratnya jelas: pengetahuan yang diajarkan harus relatif statis, tugasnya sempit dan berfrekuensi tinggi, dan sitasi sumber tidak wajib.
Kelemahannya juga harus dipahami. Fine-tuning butuh dataset yang dikurasi dengan baik dan komputasi GPU yang tidak murah. Lebih penting lagi, pengetahuan yang dimasukkan ke bobot model sulit dikelola: data tidak bisa “dihapus” semudah menghapus dokumen, dan setiap kali pengetahuan berubah, siklus retraining harus diulang. Untuk data proprietary yang sensitif, ini jadi pertimbangan tata kelola yang serius.
RAG vs Fine-Tuning: Perbandingan Langsung
Tabel berikut merangkum perbedaan keduanya berdasarkan kriteria yang paling sering jadi bahan pertimbangan tim produk.
| Kriteria | RAG | Fine-Tuning |
|---|---|---|
| Tujuan utama | Menambah pengetahuan faktual dari sumber eksternal | Mengubah gaya, format, atau perilaku model |
| Kesegaran data | Sangat baik, update dokumen langsung tercermin | Buruk, butuh retraining untuk fakta baru |
| Biaya implementasi | Rendah sampai sedang, cepat disiapkan | Tinggi, butuh dataset dan GPU |
| Biaya operasional | Murah untuk data berubah, update = ganti dokumen | Mahal untuk data berubah, retraining berulang |
| Risiko halusinasi | Rendah, jawaban terikat konteks yang diambil | Sedang sampai tinggi pada fakta baru |
| Atribusi sumber | Mudah, bisa menunjuk dokumen rujukan | Tidak mungkin, pengetahuan menyatu di bobot |
| Keahlian yang dibutuhkan | Moderat, vector DB dan integrasi API | Tinggi, ML ops dan kurasi data |
| Latensi | Tambahan langkah retrieval | Satu langkah inferensi |
| Tata kelola data | Data tetap di penyimpanan sendiri yang terkontrol | Data menyatu ke bobot, sulit dicabut |
Perbandingan di atas sejalan dengan analisis mendalam dari Sphere Inc tentang keputusan RAG vs fine-tuning dan perbandingan praktis The Decoded Media, yang sama-sama menyimpulkan bahwa keduanya bukan kompetitor melainkan pelengkap. Sudut pandang berbahasa Inggris atas topik yang sama tersedia di artikel RAG vs fine-tuning edisi Inggris Grafisify.
Lima Pertanyaan Kunci untuk Memutuskan
Daripada berdebat soal teori, jawab lima pertanyaan berikut secara berurutan. Kerangka ini diadaptasi dari panduan praktis lima isyarat pemilihan pendekatan AI untuk data enterprise dan terbukti memangkas waktu diskusi arsitektur secara signifikan.
1. Masalahnya ada di bentuk output atau di isi konten? Kalau yang bermasalah adalah format, nada, atau kosakata jawaban, bukan faktanya, mulai dari prompt engineering dulu. Kalau prompt yang dirancang hati-hati plus contoh few-shot tidak cukup, barulah pertimbangkan fine-tuning.
2. Apakah informasinya berubah tiap minggu, tiap bulan, atau per pelanggan? Kalau ya, jawabannya RAG. Apa pun yang sifatnya bisa berubah sebaiknya disimpan di luar bobot model.
3. Apakah setiap jawaban harus bisa menunjukkan sumbernya untuk audit? Kalau ya, RAG adalah satu-satunya pilihan yang masuk akal. Atribusi adalah sifat bawaan arsitektur retrieval, bukan sesuatu yang bisa ditambahkan belakangan ke model fine-tune.
4. Apakah perilakunya stabil, berfrekuensi tinggi, dan mahal kalau harus dijelaskan ulang di setiap prompt? Kalau ya, fine-tuning layak dipertimbangkan. Tugas seperti klasifikasi atau ekstraksi yang diulang ribuan kali sehari adalah kandidat ideal.
5. Apakah lebih dari satu pertanyaan di atas jawabannya ya? Kalau ya, gabungkan. Sistem produksi paling kuat biasanya di-fine-tune untuk format dan memakai RAG untuk fakta, dalam satu alur yang sama. Panduan pemula RAG vs fine-tuning merangkumnya dengan apik: RAG menambah pengetahuan, fine-tuning menambah kemampuan.
Catatan penting: dengan context window model modern yang makin besar, ada kasus di mana retrieval bisa dilewati untuk korpus kecil yang stabil, cukup memuat semuanya ke prompt. Ini berhenti bekerja ketika korpus melebihi kapasitas window, biaya per token membengkak seiring trafik, atau auditor bertanya dari mana sebuah klaim berasal.
Kesalahan Umum yang Sering Terjadi
Memakai fine-tuning untuk pengetahuan yang cepat berubah. Ini kesalahan paling mahal. Setiap update pengetahuan memaksa retraining penuh, dan di sela-sela siklus itu model menyajikan fakta basi dengan penuh percaya diri.
Memakai RAG untuk masalah perilaku. Kalau output harus selalu dalam format ketat, mengandalkan retrieval tidak menyelesaikan apa-apa. Model tetap bisa menjawab dengan format yang berantakan meski faktanya benar.
Mengabaikan kualitas retrieval. RAG yang buruk hampir selalu disebabkan oleh retrieval yang buruk, bukan modelnya. Chunking asal-asalan, embedding yang tidak cocok domain, dan tidak adanya reranking membuat model menjawab dari konteks yang salah. Investasi di kualitas retrieval sering memberi hasil lebih besar daripada ganti model yang lebih mahal.
Dataset fine-tuning yang kotor. Model yang dilatih dengan contoh tidak konsisten akan mempelajari ketidakkonsistenan itu. Kurasi dataset adalah 80 persen pekerjaan fine-tuning yang sesungguhnya.
Lupa menghitung total biaya kepemilikan. RAG terlihat murah di awal tapi biaya inferensi per query (embedding + retrieval + prompt panjang) menumpuk pada skala besar. Fine-tuning mahal di awal tapi murah per query. Hitung dengan proyeksi trafik 12 bulan, bukan biaya minggu pertama. Untuk eksperimen lokal sebelum berkomitmen ke infrastruktur cloud, optimasi konteks Ollama untuk workload lokal ringan bisa jadi titik awal yang hemat. Dua referensi tambahan dalam bahasa Inggris: perbandingan runtime LLM lokal Ollama vs llama.cpp dan cara menjalankan AI privat di laptop dengan Ollama.
Kesimpulan Final dan Langkah Berikutnya
Tidak ada pemenang mutlak antara RAG dan fine-tuning karena mereka menjawab pertanyaan yang berbeda. RAG menjawab “dari mana model tahu ini”, fine-tuning menjawab “bagaimana model seharusnya bertingkah”. Proyek AI yang matang biasanya butuh jawaban untuk keduanya.
Mulai dari yang paling murah dan paling bisa dibalik: prompt engineering untuk perilaku, RAG untuk pengetahuan. Naik ke fine-tuning hanya ketika ada bukti konkret bahwa pendekatan yang lebih ringan tidak mencapai konsistensi yang dibutuhkan. Keputusan arsitektur yang baik bukan yang paling canggih, tapi yang paling murah untuk diubah ketika kebutuhan bergeser.
Kalau proyeknya melibatkan otomasi yang lebih luas, panduan setup n8n self-hosted dan setup Docker MCP server untuk workflow AI coding membahas fondasi infrastrukturnya. Untuk analisis strategi yang lebih dalam, artikel Kairntech tentang memilih pendekatan AI yang tepat layak dibaca sebagai pelengkap.
Pertanyaan untuk didiskusikan: di proyek AI yang sedang dikerjakan sekarang, masalah terbesarnya ada di kebenaran fakta atau di konsistensi perilaku? Jawaban atas pertanyaan itu biasanya langsung menunjuk ke pendekatan yang tepat.