
Mitos vs Fakta Local LLM vs Cloud AI: Mana yang Lebih Efisien untuk Workflow Pengembang?
 Irfan Mulyana
September 18, 2026 7:34 pm
.
8 min read
Verdict Cepat
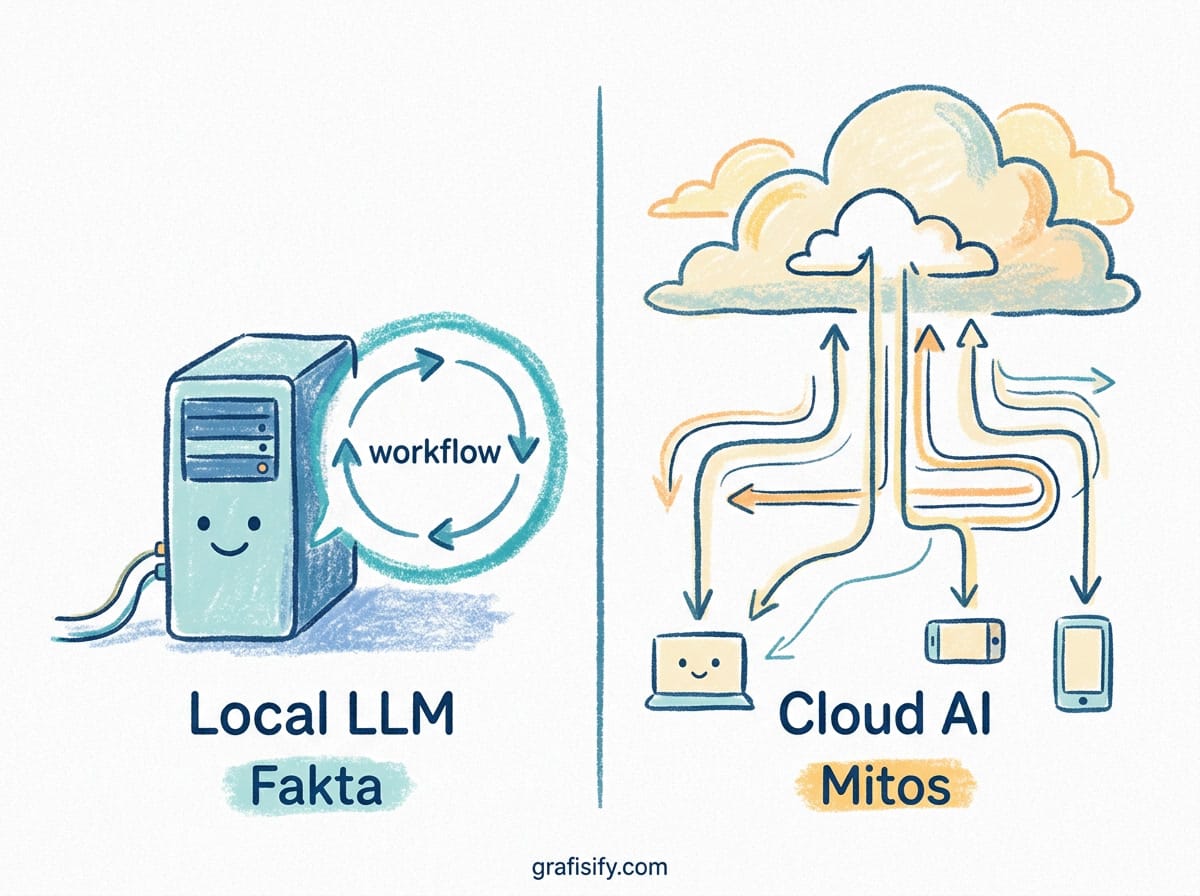
Klaim “local LLM sekarang sama bagusnya dengan cloud AI” sudah menyebar ke mana-mana. Sebagian benar, sebagian besar kabur. Local LLM memang makin mumpuni untuk tugas harian, tetapi perbedaan kualitas untuk pekerjaan analisis kompleks masih nyata. Pertanyaan yang benar bukan mana yang lebih unggul secara mutlak, melainkan tugas seperti apa yang sedang dihadapi saat ini.
Saya sudah mencoba kedua jalur ini untuk pekerjaan harian, dan pola yang konsisten muncul bisa diringkas begini: arahkan pekerjaan ke tempat karakteristiknya cocok. Bukan pilih satu lalu memaksanya untuk segala hal. Saya meyakini bahwa pemahaman yang jernih soal titik impas dan batas kemampuan jauh lebih berguna daripada perdebatan ideologis tanpa data.
Mitos 1: Local LLM Sudah Menyamai Cloud untuk Semua Tugas
Klaim ini paling sering diulang, dan paling mudah dibantah. Data benchmark yang banyak dikutip menunjukkan local LLM seperti Qwen 3 7B meraih skor HumanEval sekitar 76.0 pada kuantisasi Q4_K_M. Angka itu memang bagus untuk model berukuran 5.5 hingga 6 GB. Masalahnya, perbandingan langsung dengan model cloud sering tidak disertakan dalam tabel yang sama. Klaim paritas yang didasarkan pada benchmark yang tidak pernah mengukur lawan bandingnya adalah klaim yang tidak terverifikasi.
Pengujian mendalam di 2026 menemukan pola yang lebih jujur. Untuk sekitar 80% tugas profesional, termasuk penulisan, bantuan kode rutin, dan peninjauan dokumen, local LLM seperti Llama 4 Scout atau Qwen 3.6 27B sudah kompetitif. Selisih kualitasnya dengan model frontier seperti GPT-5.5 atau Claude Opus 4.5 tidak terlalu terasa. Tetapi untuk 10 hingga 20% tugas tersisa, yaitu penalaran tingkat frontier, matematika kompetisi, dan debugging lintas-sistem yang kompleks, model cloud masih memimpin dengan margin yang terlihat.
Training scale menjadi alasan utamanya. Model frontier cloud dilatih dengan data dan komputasi berorde lebih besar dibanding model publik yang bisa berjalan di hardware konsumen. Pada tugas di batas kemampuan, jurang ini terlihat jelas. Pada tugas harian, jurangnya tidak terlihat. Itulah mengapa klaim paritas terdengar masuk akal bagi banyak orang, sekaligus mengapa klaim itu tetap tidak akurat sebagai pernyataan umum.
Mitos 2: Cloud Selalu Lebih Murah dalam Jangka Pendek
Argumen biaya sering disampaikan dengan cara yang menyesatkan. Pihak yang mendukung cloud menunjukkan bahwa satu sesi tutorial memakai API hanya habis sekitar 0.05 dolar, lalu menyimpulkan bahwa membeli hardware untuk local LLM tidak masuk akal. Pihak yang mendukung local menunjukkan biaya API per juta token, lalu menyimpulkan bahwa cloud menggerus dompet. Keduanya benar pada skala yang berbeda.
Titik impas yang terukur memberikan gambaran lebih jelas. Asumsikan server GPU kelas menengah sekitar 2.500 dolar per bulan dan harga API sekitar 1.50 dolar per juta token output. Titik impasnya ada di rentang 5 hingga 10 juta token output per bulan. Di bawah angka itu, cloud hampir selalu menang pada total biaya kepemilikan setelah waktu DevOps diperhitungkan. Di atas 10 juta token, hardware sendiri biasanya menghemat 40 hingga 60% dalam 12 bulan jika utilisasi GPU terjaga.
Faktor tersembunyi di sisi local adalah waktu. Menjalankan local LLM bukan sekadar instal dan lupa. Diperlukan seseorang yang mengelola driver GPU, versioning model, framework serving seperti vLLM atau Ollama, serta uptime. Tim tanpa engineer infrastruktur khusus akan menghabiskan biaya operasional yang melebihi tagihan API. Perhitungan 20 hingga 40% waktu satu engineer untuk pemeliharaan rutin adalah angka yang realistis.
Baca juga:
Mitos 3: Privasi Hanya Soal Kepatuhan Regulasi
Banyak tim memandang privasi sebagai urusan departemen hukum, sesuatu yang aktif hanya bila ada PHI, PII, atau data finansial yang diatur GDPR, HIPAA, atau SOC 2. Pandangan ini melewatkan satu risiko praktis: data sensitif secara bisnis tidak selalu terdaftar dalam klasifikasi regulasi.
Bentuk produk yang sedang dibangun, strategi yang dipertimbangkan, batasan proyek yang dirahasiakan, atau taruhan yang sudah ditolak, semuanya adalah informasi yang tidak ada di formulir kepatuhan mana pun. Namun setiap byte itu mengalir melalui server pihak ketiga bila inference-nya di cloud. Local LLM membuat inference data tidak pernah meninggalkan mesin. Kebijakan vendor tidak bisa mengubahnya. Tidak ada langganan yang bisa dibatalkan dan membawa serta data tersebut.
Bagi sebagian besar pengguna, karakteristik privasi cloud memang dapat diterima. Tetapi untuk pekerjaan hukum, medis, finansial, atau bisnis yang benar-benar sensitif, local adalah satu-satunya pilihan yang memberikan kontrol nyata. Pertanyaan kuncinya bukan apakah cloud provider dapat dipercaya, melainkan apakah Anda ingin menggantungkan diri pada kepercayaan itu untuk data paling sensitif yang Anda miliki.
Mitos 4: Latensi Cloud Tidak Terlalu Dirasakan
Cloud API menambahkan round-trip jaringan sebelum token pertama muncul, biasanya 50 hingga 200ms. Pada paper terlihat seperti angka yang tidak signifikan. Pada praktiknya, untuk aplikasi interaktif, angka inilah yang membedakan alur kerja yang mulus dari yang terasa tersendat.
Inference local pada GPU modern menghasilkan token pertama dalam hitungan puluhan milidetik tanpa ketergantungan jaringan. Variansinya juga lebih rendah karena tidak bersaing dengan pengguna lain memperebutkan waktu GPU atau antrian di sisi provider. Untuk asisten suara, saran kode real-time, atau sistem kontrol industri, selisih ini bersifat menentukan.
Ada ironi di sini. Model local berukuran kecil, seperti Qwen 3 7B pada RTX 4090, memang lebih cepat dalam generasi token mentah dibanding model cloud. Tetapi model local berukuran 70B justru jauh lebih lambat. Perbandingan kecepatan bergantung sepenuhnya pada model mana yang dijalankan secara local. Klaim “local selalu lebih cepat” sama kelirunya dengan klaim “cloud selalu lebih cepat”.
Tabel Perbandingan: Local vs Cloud per Dimensi
| Dimensi | Local LLM | Cloud AI |
|---|---|---|
| Kualitas output (tugas harian) | Kompetitif, selisih kecil | Sedikit unggul, tak terasa |
| Kualitas output (penalaran frontier) | Tertinggal di 10-20% tugas terberat | Unggul dengan margin nyata |
| Kecepatan token pertama | Puluhan milidetik, varian rendah | 50 hingga 200ms plus antrian |
| Biaya (di bawah 5 juta token/bulan) | Kalah setelah hitung waktu DevOps | Lebih murah dan lebih sederhana |
| Biaya (di atas 10 juta token/bulan) | Hemat 40 hingga 60% per tahun | Mahal, terus meningkat |
| Privasi data | Tidak meninggalkan mesin | Diproses pihak ketiga |
| Fitur terbaru (vision, tool use) | Tertinggal beberapa minggu | Paling awal tersedia |
Mitos 5: Pilihan Harus Salah Satu Saja
Di luar dugaan banyak orang, pola dominan di tim skala menengah hingga besar pada 2026 bukan local atau cloud, melainkan local dan cloud secara bersamaan. Arsitektur hibrida yang sengaja merutekan setiap permintaan ke backend yang paling sesuai.
Tim engineering di banyak perusahaan memakai pola yang konsisten: cloud untuk lingkungan development dan staging, self-hosted untuk production. Cloud memberi developer akses cepat ke model frontier tanpa menunggu tim ops menyiapkan hardware. Production workload, yang menyumbang lebih dari 90% volume token, berjalan di hardware milik sendiri di mana ekonominya menguntungkan. Staging tidak menyentuh data sensitif production, sehingga cloud aman di sana.
Implementasi sederhana memakai satu proxy layer yang memeriksa setiap permintaan dan merutekannya. Permintaan volume tinggi dan tugas sederhana pergi ke local model, gratis setelah amortisasi hardware. Data sensitif pergi ke local model, tidak pernah meninggalkan infrastruktur. Interaksi yang sensitif terhadap latensi pergi ke local model. Sedangkan permintaan yang membutuhkan kemampuan frontier atau melebihi kapasitas local, naik ke cloud API.
Langkah praktis pertama: standarkan satu abstraction layer seperti LiteLLM atau OpenRouter, agar kode aplikasi tidak peduli apakah ia memanggil endpoint local atau cloud API. Lalu pasang peringatan biaya otomatis di 80% anggaran API bulanan. Saat peringatan itu berbunyi, itulah saat untuk evaluasi ulang apakah beban kerja sudah melintasi ambang migrasi ke local.
Pertanyaan Empat Langkah untuk Memilih
Saya menyusun rangkaian pertanyaan ini dari sumber-sumber terverifikasi di atas. Kerjakan secara berurutan, berhenti pada jawaban pertama yang definitif.
Pertama, apakah datanya sensitif? Bila ya, self-hosted adalah pilihan default, kecuali ada opsi cloud yang terverifikasi tanpa retensi. Bila tidak, lanjut.
Kedua, apakah volume token bulanan di atas 10 juta token output? Bila ya, self-hosted kemungkinan menang dari sisi biaya, validasikan dengan model total biaya kepemilikan sendiri. Bila tidak, lanjut.
Ketiga, apakah tim punya kapasitas DevOps atau MLOps khusus? Bila tidak, cloud API adalah jalurnya. Bila ya, lanjut.
Keempat, apakah ada SLA latensi di bawah 150ms time-to-first-token? Bila ya, local atau edge adalah satu-satunya pilihan. Bila tidak, cloud API atau hibrida bila volume mendekati titik impas.
Bila sampai di akhir tanpa jawaban yang jelas, berarti wilayah operasional adalah hibrida. Itulah di mana sebagian besar workload enterprise 2026 sebenarnya berada.
Prediksi ke Mana Arah Ini Selanjutnya
Tooling untuk local inference dewasa setiap bulan. Satu perintah setup, kuantisasi otomatis, dan utilisasi GPU yang membaik sudah menurunkan barier masuk secara signifikan dibanding dua tahun lalu. Yang masih berbeda adalah ceiling kemampuan. Model paling mumpuni hanya tersedia melalui API, dan jurang antara frontier dan open-weight tetap ada untuk tugas penalaran kompleks.
Yang konvergen adalah tooling. Yang tetap terpisah adalah ceiling. Perbedaan ini penting dipahami sebelum berinvestasi pada salah satu sisi secara penuh.
Kesimpulan
Perdebatan local versus cloud bukan pertanyaan ideologi, melainkan pertanyaan mencocokkan infrastruktur dengan ekonomi beban kerja. Mitos paritas menutupi kenyataan bahwa model local memang sudah mumpuni untuk mayoritas tugas profesional, tetapi bukan untuk semuanya. Argumen biaya satu sisi sama buruknya dengan argumen biaya sisi lainnya bila konteksnya tidak diperjelas. Privasi sering hanya dilihat dari kacamata kepatuhan regulasi, padahal risiko bisnisnya nyata. Dan pilihan biner sendiri adalah mitos terbesar dari semuanya.
Jalur pragmatis untuk kebanyakan tim: mulai dari cloud, ukur penggunaan asli, lalu pindahkan workload ke local hardware seiring volume tumbuh. Jalur pragmatis untuk tim yang sudah punya kapasitas infrastruktur: jalankan stack hibrida, self-host model 7B hingga 14B untuk tugas volume tinggi, arahkan permintaan kompleks ke cloud. Umumnya ini memangkas pengeluaran cloud 40 hingga 60% sambil mempertahankan kemampuan.
Untuk pekerjaan harian penulisan, analisis standar, dan bantuan kode, local sudah cukup. Simpan akses cloud untuk 10 hingga 20% tugas di mana kualitas frontier terlihat bedanya. Itu porsi terkecil, tetapi sering bagian tersulit dari pekerjaan.