
Context Engineering: Seni Menyusun Konteks untuk AI
 Irfan Mulyana
October 15, 2026 7:22 am
.
10 min read
Verdict: Ringkasan Cepat
Verdict Cepat: Output AI yang jelek jarang disebabkan model yang lemah. Penyebabnya hampir selalu konteks yang buruk. Context engineering, yaitu seni menyusun seluruh informasi yang diterima model, menentukan kualitas hasil lebih besar daripada sekadar mengganti model. Kuasai lima komponen konteks di bawah, terapkan teknik lanjutan untuk AI agent, dan hasil kerja dengan AI berubah drastis.
Bukan Modelnya, Konteksnya
Harga model AI terus turun. GPT-6.1 Sol meluncur di OpenAI DevDay pada 29 September dengan tarif $2 per satu juta token input dan $10 per satu juta token output. Claude Haiku 5.5 hadir dengan context window satu juta token, tarif $0.10 per satu juta token input dan $0.50 per satu juta token output. Model frontier makin murah, context window makin besar, tapi keluhan tentang hasil AI tetap sama: generik, tidak nyambung, atau salah arah.
Masalahnya bukan di model. Masalahnya ada pada apa yang dikirim ke model. Prompt satu baris seperti “buatkan caption Instagram” memberi model ruang tebak-tebakan yang sangat luas. Model menebak audiens, menebak gaya bahasa, menebak panjang teks, menebak tujuan. Hasil tebakan itu wajar kalau terasa generik. Model tidak punya akses ke kepala penulis prompt.
Saya melihat pola yang sama berulang kali: orang mengganti model tiga kali, lalu menyimpulkan AI tidak cocok untuk pekerjaannya. Padahal prompt yang dipakai sama persis, konteks yang dikirim sama persis. Mengganti model tanpa memperbaiki konteks seperti mengganti mesin mobil tanpa mengisi bensin. Mesin baru tidak menyelesaikan masalah bahan bakar yang kosong.
Lyzr dalam panduan prompt engineering 2026 mencatat pergeseran penting: prompt engineering tidak mati, tapi pusat gravitasinya pindah. Dulu orang menulis prompt untuk chatbot. Sekarang pekerjaan bernilai tinggi ada di merancang system prompt dan konteks untuk AI agent yang bekerja otonom. Istilah yang dipakai industri untuk disiplin ini adalah context engineering. Artikel ini membahasnya dari sisi praktis: komponen, teknik, kesalahan umum, dan studi kasus nyata.
Prompt engineering klasik fokus pada kalimat perintah: susunan kata, gaya instruksi, urutan kalimat. Context engineering lebih luas. Ia mencakup seluruh informasi yang diterima model dalam satu sesi kerja: system prompt, instruksi user, contoh referensi, dokumen yang dilampirkan, hasil pemanggilan tool, riwayat percakapan, bahkan memori dari sesi sebelumnya.
Analogi sederhana: prompt engineering adalah menulis satu surat perintah. Context engineering adalah menyiapkan seluruh meja kerja sebelum orang mulai bekerja, lengkap dengan berkas referensi, contoh hasil yang diharapkan, batas wewenang, dan prosedur kalau ada masalah. Orang yang sama menghasilkan kerja yang jauh lebih baik di meja yang rapi dibanding meja yang berantakan. Model AI bekerja dengan prinsip yang sama.
Perbedaan ini penting karena context window modern sudah sangat besar. Satu juta token terdengar seperti kebebasan total, tapi konteks yang besar bukan konteks yang baik. Menjejalkan 80 dokumen ke dalam prompt tidak otomatis membuat model lebih pintar. Justru sebaliknya: informasi yang tidak relevan mengaburkan sinyal yang penting. Context engineering justru sering berarti mengurangi, bukan menambah. Memilih apa yang masuk, membuang apa yang mengganggu, menyusun urutan yang membantu model bernalar.
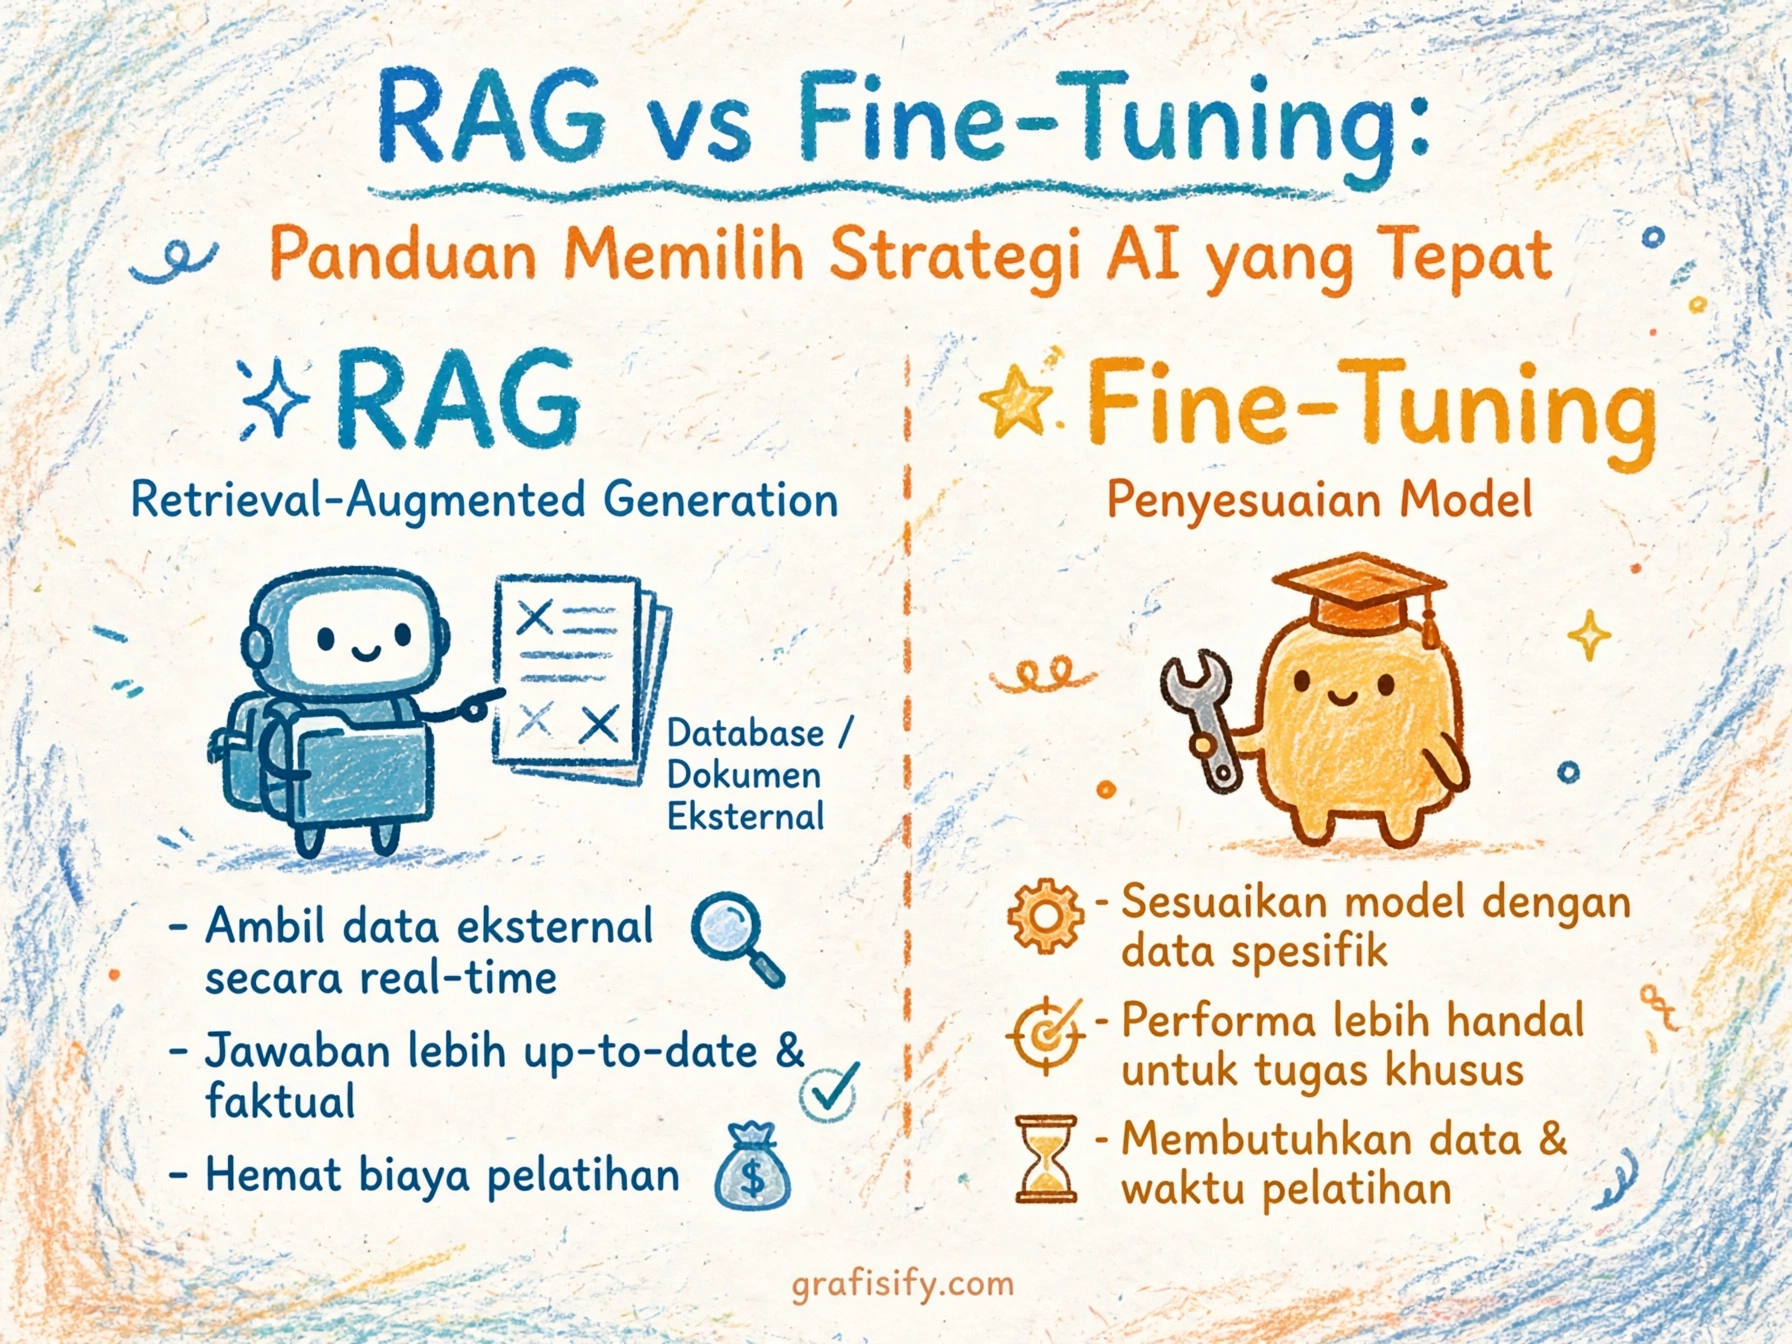
Bagi yang sedang mempertimbangkan antara RAG dan fine-tuning untuk kebutuhan AI yang lebih serius, perbandingan RAG vs fine-tuning di Grafisify membahas kapan setiap pendekatan layak dipakai. Context engineering duduk satu lapis di bawah keduanya: ia adalah fondasi yang membuat RAG bekerja baik dan membuat fine-tuning tidak sia-sia.
Lima Komponen Konteks yang Menentukan Hasil
Setelah menguji berbagai pola prompt untuk pekerjaan konten dan riset, Saya merumuskan lima komponen yang selalu menentukan kualitas output. Hilangkan satu, hasil langsung terasa.
Pertama, peran dan cakupan. Model perlu tahu ia berperan sebagai apa dan batas wewenangnya di mana. “Bertindaklah sebagai editor naskah berpengalaman” memberi kerangka penilaian yang berbeda dari prompt tanpa peran. Cakupan sama pentingnya: “jawab hanya berdasarkan materi kursus ini” mencegah model mengarang dari pengetahuan umum. Tanpa cakupan, model bebas mengisi kekosongan dengan halusinasi.
Kedua, latar belakang tugas. Model tidak boleh menebak konteks bisnis. Sampaikan siapa audiensnya, apa tujuannya, dan situasi seperti apa yang dihadapi. Perintah “tulis email follow-up” tanpa latar menghasilkan email generik. Tambahkan “klien UMKM yang belum membalas penawaran desain logo selama seminggu, tujuannya mengingatkan tanpa terkesan memaksa”, hasilnya langsung berubah spesifik dan bisa dipakai.
Ketiga, contoh referensi. Satu contoh hasil yang bagus mengalahkan tiga paragraf penjelasan. Teknik ini disebut few-shot prompting: beri model satu atau dua contoh output yang diinginkan, model meniru polanya. Contoh tidak harus panjang. Contoh caption yang disukai, contoh format laporan yang dipakai tim, contoh gaya penulisan brand. Model meniru pola lebih baik daripada mengikuti deskripsi pola.
Keempat, kontrak output. Tentukan format hasil secara eksplisit: panjang teks, struktur heading, format data. Untuk pekerjaan yang hasilnya diproses mesin, kontrak output wajib dalam bentuk skema JSON: “jawab HANYA dengan JSON valid sesuai skema ini”. Instruksi format yang tegas mengurangi kebutuhan bersih-bersih manual setelah model menjawab.
Kelima, aturan main dan batasan. Untuk AI agent yang memanggil tool, komponen ini krusial: berapa kali maksimal ia boleh mencoba, apa yang dilakukan kalau buntu, kapan harus berhenti dan bertanya ke manusia. Tanpa aturan main, agent bisa berputar-putar memanggil tool yang sama puluhan kali atau mengambil tindakan yang seharusnya butuh persetujuan manusia.
Teknik Lanjutan untuk AI Agent
Prompt untuk chatbot cukup dengan lima komponen di atas. AI agent yang memegang tool butuh lapisan tambahan. Framework open source n8n-agent-prompt-master merangkum sepuluh teknik yang dipakai di production, dan beberapa di antaranya layak dipahami siapa pun yang membangun agent.
Minimal viable toolset. Jangan beri agent dua tool yang fungsinya tumpang tindih. Pilihan yang ambigu membuat agent salah memilih tool atau bergantian memakai keduanya tanpa hasil. Satu tugas, satu tool terbaik.
Tool intent anchoring. Kalau agent terus memanggil tool yang salah, solusinya bukan mempertegas prompt dengan huruf kapital. Tuliskan di deskripsi setiap tool kapan tool itu dipakai dan kapan tidak. Deskripsi tool adalah prompt juga, dan ia dibaca setiap kali agent mempertimbangkan pemanggilan.
Loop budget dan escalation path. Tetapkan batas maksimal pemanggilan tool, misalnya sepuluh kali, lalu definisikan apa yang terjadi setelah batas tercapai: berhenti, rangkum progres, dan serahkan ke manusia. Agent tanpa loop budget bisa menghabiskan token dan waktu untuk masalah yang sebenarnya butuh keputusan manusia.
Deklarasi HITL. Human-in-the-loop bukan sekadar tulisan “minta konfirmasi dulu” di prompt. n8n menambahkan dukungan HITL native per tool pada Januari 2026: workflow berhenti secara deterministik sampai manusia menyetujui atau menolak pemanggilan tool tertentu. System prompt harus menyatakan tool mana yang digate dan bagaimana agent menangani penolakan. Konfirmasi berbasis prompt bersifat probabilistik, bisa diabaikan model. Gate berbasis workflow tidak bisa dinegosiasi.
Context pruning. Agent yang berjalan lebih dari sepuluh turn menumpuk riwayat yang makin panjang dan makin berisik. Instruksikan agent untuk merangkum progres secara berkala dan membuang detail yang sudah tidak relevan. Tanpa pruning, agent lama-lama “lupa” tujuan awal karena tenggelam dalam riwayatnya sendiri.
Prinsip paling tajam dari framework ini: kalau agent terus melewatkan langkah wajib, solusinya bukan prompt yang lebih tegas. Pindahkan langkah itu ke workflow. Aturan yang harus terjadi 100 persen dari waktu dijadikan node deterministik, bukan instruksi bahasa alami. Prompt mengatur perilaku yang butuh penilaian. Workflow mengatur perilaku yang butuh kepastian.
Perbandingan Pendekatan: Pilih yang Sesuai Kebutuhan
Context engineering bukan satu-satunya cara meningkatkan hasil AI. Tabel berikut menempatkannya di antara pendekatan lain agar tidak tertukar.
| Pendekatan | Fokus | Biaya Relatif | Kapan Dipakai | Keterbatasan |
|---|---|---|---|---|
| Prompt engineering klasik | Merumuskan instruksi yang jelas | Gratis, instan | Tugas sekali jalan, chatbot harian | Tidak scalable untuk workflow kompleks |
| Context engineering | Merancang seluruh konteks: contoh, dokumen, tool, aturan | Rendah, butuh waktu perancangan | AI agent, workflow berulang, tim | Butuh pemahaman cara model bernalar |
| RAG | Mengambil dokumen relevan dari basis pengetahuan | Menengah, butuh infrastruktur | Jawaban berbasis dokumen internal perusahaan | Kualitas tergantung retrieval, bukan prompt |
| Fine-tuning | Melatih ulang model dengan data khusus | Tinggi, butuh data dan komputasi | Gaya, format, atau domain sangat spesifik | Mahal, lambat diulang, bisa overfit |
Urutan yang masuk akal untuk kebanyakan tim: mulai dari context engineering. Ia murah, cepat diiterasi, dan sering menyelesaikan 80 persen masalah. Naik ke RAG kalau model butuh pengetahuan yang tidak ada dalam pelatihannya. Pertimbangkan fine-tuning hanya kalau gaya output yang konsisten tidak bisa dicapai dengan contoh dan instruksi. Banyak tim melompat ke fine-tuning terlalu dini, padahal konteksnya yang berantakan. Untuk panduan memilih strategi AI yang lebih mendalam, baca juga panduan memilih framework AI agent untuk tim.
Studi Kasus: 47 Ribu Baris Kode dalam Enam Jam
Contoh paling ekstrem yang Saya temukan datang dari praktisi yang membangun presentasi tentang context engineering dengan memakai context engineering itu sendiri. Ia menambang riwayat percakapannya, menyintesis studi kasus 85KB, membuat spesifikasi detail, lalu menjalankan agent paralel untuk membangun slide sementara sistem tracking memantau progres.
Angkanya: lebih dari 20 agent paralel, 80 dokumen riset, 175.000 baris riset, 47.000 baris kode production, waktu total sekitar enam jam, dan nol commit perbaikan ulang. Detail lengkapnya bisa dibaca di studi kasus context engineering tersebut.
Teknik yang membuatnya berhasil bukan sulap. Pertama, referensi file daripada menempel isi: agent diberi pointer ke file, bukan disuapi teks panjang yang menggelembungkan konteks. Kedua, swarm paralel untuk riset luas, lalu sintesis yang ditunda sampai semua riset selesai. Ketiga, undangan bertanya: agent didorong mengajukan pertanyaan untuk membongkar asumsi sebelum bekerja. Keempat, rekomendasi yang dipaksa: riset harus berakhir dengan keputusan, bukan tumpukan catatan.
Pelajaran untuk pekerjaan sehari-hari: konteks yang baik membuat agent cepat dan akurat, konteks yang buruk membuat agent mahal dan berputar-putar. Selisihnya bukan pada model yang dipakai, tapi pada persiapan sebelum model bekerja.
Kesalahan Umum yang Merusak Konteks
Context bloat. Godaan terbesar pemilik context window besar adalah memasukkan semuanya “biar aman”. Hasilnya sebaliknya: sinyal penting tenggelam di antara dokumen yang setengah relevan. Aturan praktis: setiap potong konteks harus menjawab pertanyaan “tanpa ini, model akan salah dalam hal apa?” Kalau tidak ada jawaban yang jelas, buang.
Mengabaikan prompt injection. OWASP menempatkan prompt injection sebagai kerentanan nomor satu pada sistem LLM. Output tool, dokumen yang diambil RAG, dan respons server MCP bisa mengandung instruksi tersembunyi yang membajak perilaku agent. Framework production selalu menyertakan bagian keamanan data: perlakukan data eksternal sebagai data, bukan sebagai instruksi. Topik ini berkaitan erat dengan risiko keamanan AI agent dan akses sistem yang pernah dibahas di Grafisify.
Memaksa lewat prompt yang seharusnya jadi workflow. Contoh klasik: agent diminta “jangan pernah menghapus file tanpa konfirmasi”. Instruksi itu kadang dipatuhi, kadang tidak, tergantung konteks sesi. Kalau aturannya mutlak, jadikan gate deterministik di workflow. Prompt untuk penilaian, workflow untuk kepastian. Mencampuradukkan keduanya adalah sumber bug agent yang paling sulit dilacak.
Tidak pernah mengevaluasi. Prompt ditulis sekali, dipakai selamanya, lalu disalahkan modelnya ketika hasil menurun. Konteks butuh versi dan pengujian seperti kode: simpan varian prompt, uji pada kasus yang sama, ukur dengan rubrik. Tool seperti LangSmith dan PromptLayer ada untuk kebutuhan ini. Tanpa evaluasi, perbaikan konteks hanya berdasarkan firasat.
Langkah Praktis dan CTA
Teori cukup. Berikut alur lima langkah yang bisa langsung dipakai untuk satu tugas nyata minggu ini, misalnya menulis konten atau meriset kompetitor.
Langkah 1: tulis tugas dalam satu kalimat. “Buatkan draf artikel 800 kata tentang tren kemasan kopi untuk audiens pemilik kafe” lebih baik daripada “tulis tentang kopi”. Kalau tugas tidak bisa diringkas dalam satu kalimat yang jelas, tugasnya belum siap dikerjakan AI.
Langkah 2: kumpulkan konteks mentah. Catat audiens, tujuan, batasan, dan materi acuan. Jangan disaring dulu, kumpulkan saja. Daftar ini adalah bahan mentah context engineering.
Langkah 3: pilih satu contoh terbaik. Satu contoh hasil yang mendekati harapan menghemat sepuluh kalimat penjelasan. Model meniru pola lebih baik daripada mengikuti deskripsi pola.
Langkah 4: tetapkan kontrak output. Panjang, struktur, format, dan hal yang dilarang, ditulis eksplisit. Kontrak yang bisa diverifikasi menghasilkan output yang bisa dipakai.
Langkah 5: uji, nilai, iterasi. Jalankan, baca hasilnya dengan kritis, catat bagian yang meleset, perbaiki komponen konteks penyebabnya. Kalau hasilnya sudah 60 persen benar, tunjukkan secara spesifik di mana 40 persen sisanya kurang. Siklus umpan balik ini mendorong kualitas ke 80 atau 90 persen pada putaran berikutnya.
Pola ini berlaku juga untuk otomasi web berbasis AI: agent browser yang diberi konteks tugas yang rapi bekerja jauh lebih andal daripada agent yang hanya diberi URL dan perintah singkat.
Verdict akhirnya sederhana. Model AI adalah komoditas yang makin murah dan makin pintar. Pembeda antara hasil generik dan hasil yang bisa dipakai bukan lagi akses ke model terbaik, tapi kemampuan menyusun konteks terbaik. Mulai dari satu tugas yang dikerjakan berulang setiap minggu, terapkan checklist lima langkah, simpan versi prompt yang berhasil, dan bandingkan hasilnya. Selisihnya terlihat dalam satu atau dua putaran. Kalau artikel ini membantu, bagikan ke rekan yang masih menyalahkan modelnya setiap kali output meleset. Masalahnya hampir pasti ada di konteks, dan sekarang ada cara sistematis untuk memperbaikinya. Untuk bahan riset lanjutan, pantau rangkuman tools AI terbaru dan laporan state of AI Oktober 2026.